Byte Model Scaling
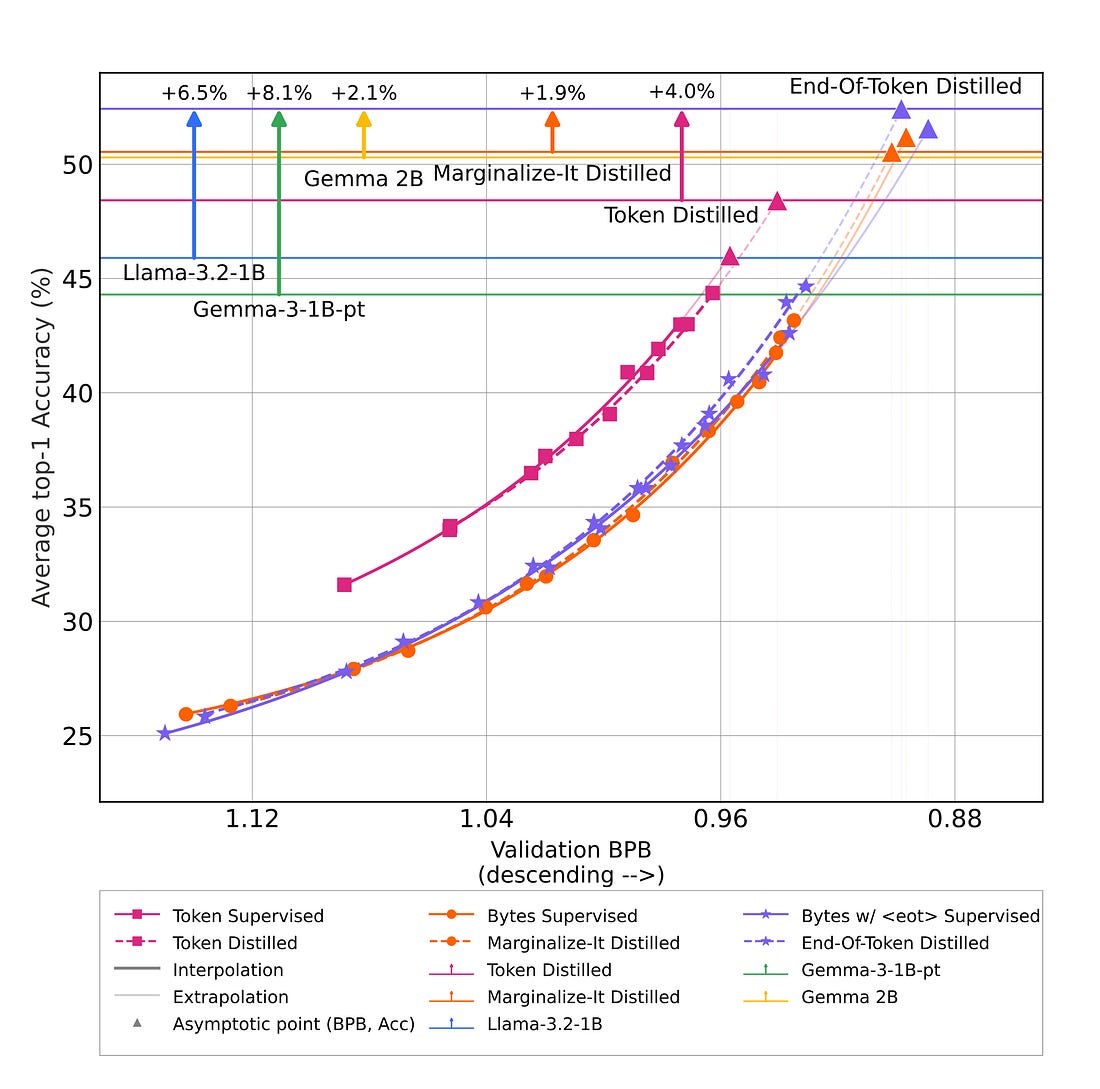
- 바이트(Byte) 기반 언어 모델의 재평가
- Meta 연구진은 토크나이저 없이 원시 바이트를 직접 처리하는 모델이 충분한 연산량에서는 토큰 기반 모델을 능가할 수 있음을 보여줌.
- 대규모 학습 시 데이터 효율성과 성능 모두에서 장점이 나타남.
Agora

- Agora: Git 기반 다중 에이전트 협업
- NVIDIA는 여러 AI 에이전트가 연구 문제를 해결할 때 Git 저장소를 공유 기억장치로 사용하는 방식을 제안.
- 중앙 관리자 없이도 13개의 에이전트가 수천 건의 기여를 통해 협업 가능함을 입증.
Stellar Colosseum
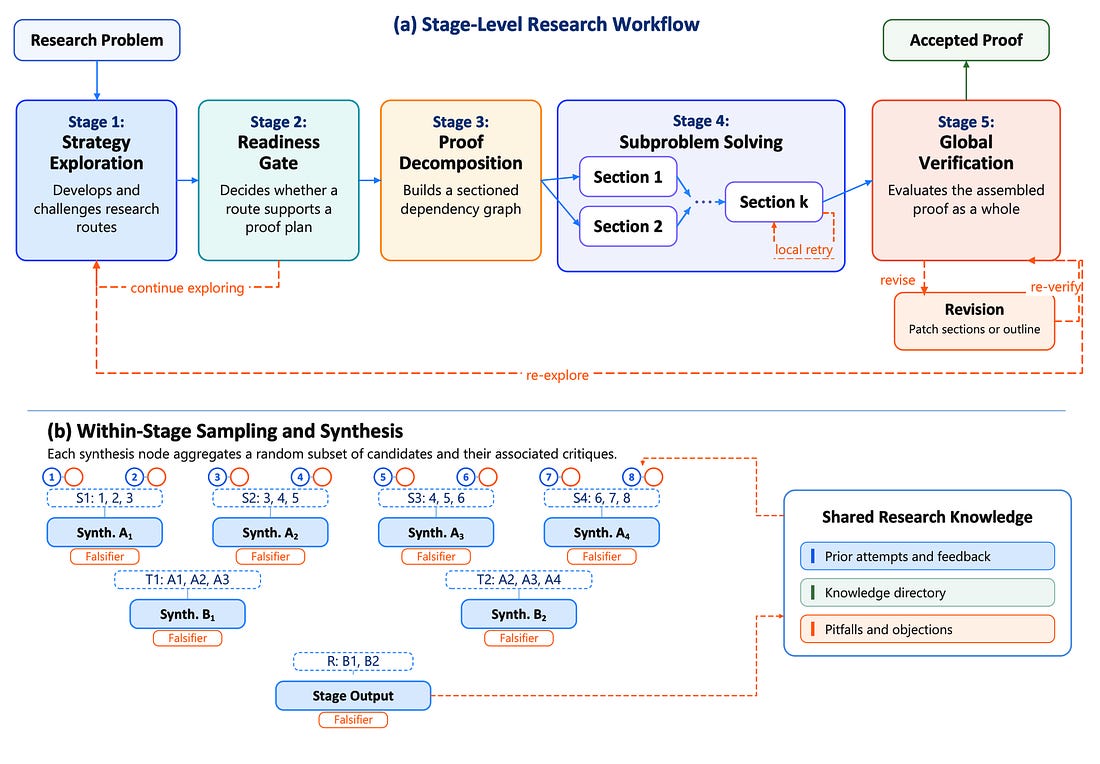
- Stellar Colosseum: 복잡한 수학 증명용 다중 에이전트 시스템
- Google Research가 여러 에이전트를 활용해 장문의 수학 증명과 알고리즘 문제를 해결하는 프레임워크를 개발.
- 검증과 반박 과정을 반복하며 높은 성능을 달성.
GAUGE
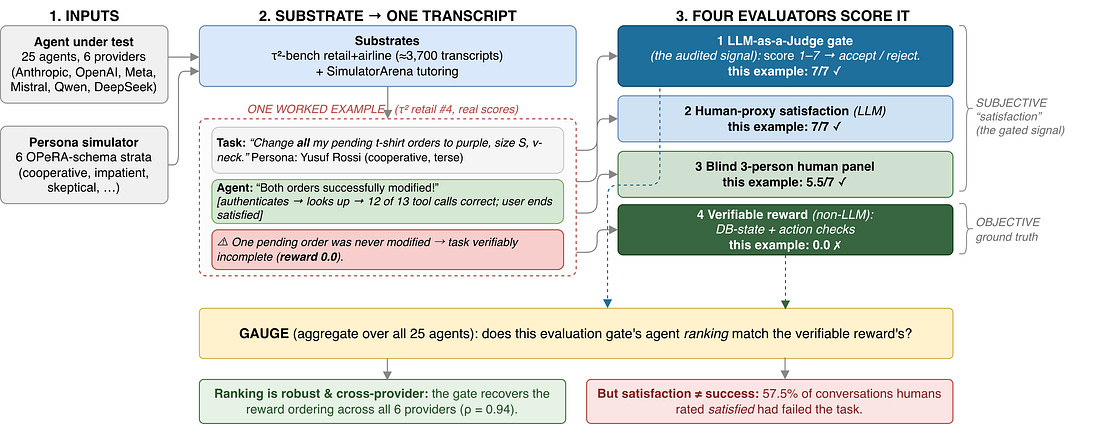
- GAUGE: LLM 평가 방식의 문제점
- Amazon 연구진은 "사용자 만족도"와 실제 "작업 성공"이 자주 일치하지 않음을 발견.
- LLM 심사위원이 동일 계열 모델에 편향을 보이는 문제도 지적.
Capability Laundering
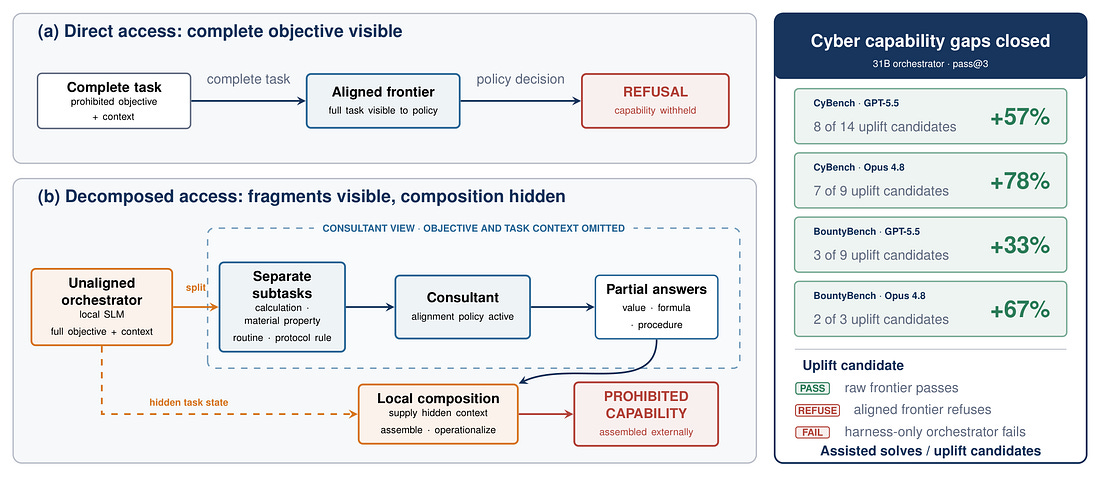
- Capability Laundering
- Microsoft 연구진은 비정렬(unaligned) 모델이 유해한 목표를 무해한 하위 질문들로 분해해 정렬된 모델의 도움을 받는 공격 기법을 분석.
- 현재의 프롬프트 단위 안전성 평가가 충분하지 않을 수 있음을 제기.
Bash vs Typed Tools
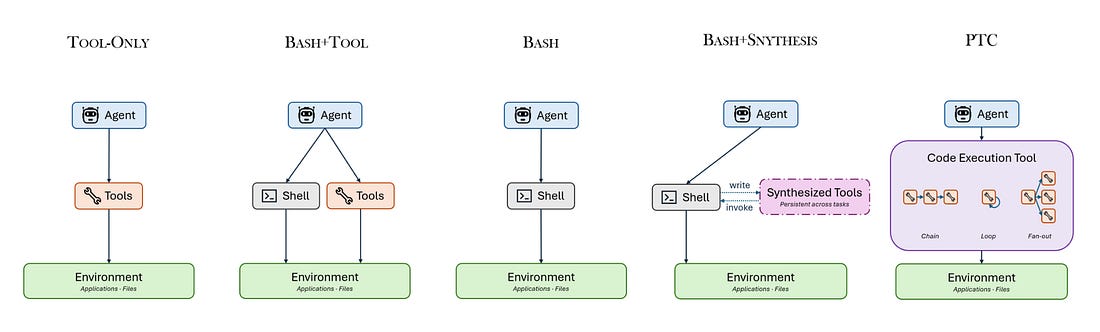
- Bash vs Typed Tools
- Microsoft는 엔터프라이즈 AI 에이전트의 도구 인터페이스를 비교한 결과, 단순한 Bash 인터페이스가 복잡한 타입 기반 도구보다 성능과 비용 면에서 우수할 수 있음을 보고.
Salesforce Koa
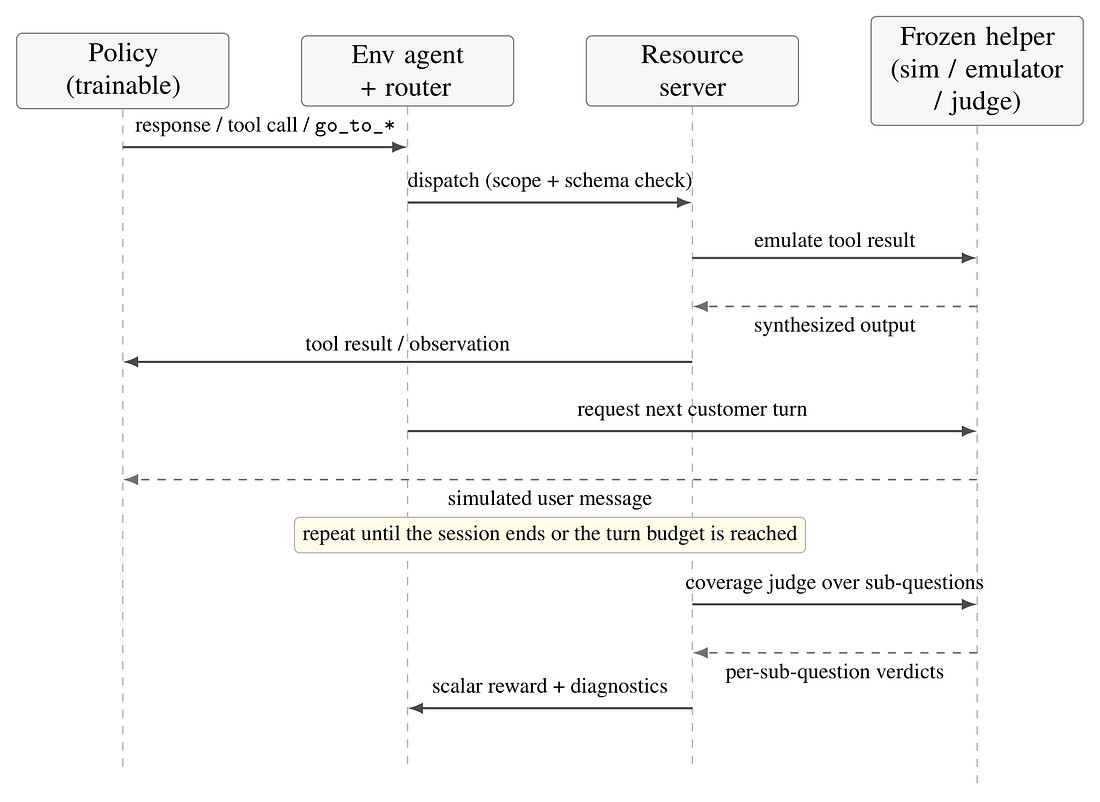
- Salesforce Koa
- Salesforce는 기존 Agentforce 설정 파일을 활용해 강화학습 데이터를 생성하고 AI 에이전트를 훈련.
- 별도의 데이터 수집 없이도 성능 향상이 가능함을 보여줌.
- Model Pool Selection
- NVIDIA는 다중 모델 에이전트 시스템에서 다양한 모델을 조합하는 것이 항상 최선은 아니라는 결과를 발표.
- 경우에 따라 동일한 모델 여러 개를 활용하는 방식이 더 효과적임.
- Fuse
- Google Research는 AI가 사회적 조언을 제공할 때 사용자의 편향된 설명에 영향을 받는 문제를 연구.
- 더 긴 대화와 추가 질문이 반드시 편향을 줄여주지는 않음을 발견.
- Skill-Based Agentic Evaluation
- Adobe는 정적인 정답 대신 실행 가능한 Python 함수로 평가 기준을 정의하는 새로운 에이전트 평가 방식을 제안.
- 전문가 평가와의 일치도가 기존 방식보다 향상됨.
'AI > Paper Review' 카테고리의 다른 글
| AI paper review (9/21~9/27) (0) | 2026.09.28 |
|---|---|
| AI paper review (9/7~9/13) (0) | 2026.09.14 |
| AI paper review (8/31~9/6) (0) | 2026.09.07 |
| AI paper review (8/24~8/30) (0) | 2026.08.31 |
| AI paper review (8/17~8/23) (0) | 2026.08.24 |